
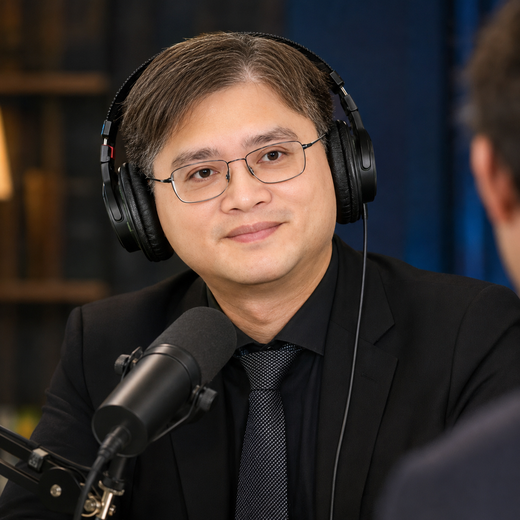
【專訪】Joon Sung Park:GPT 預測人類行為只有三成準,他要建的模型必須跟人一樣會犯錯
市調公司每年花幾百萬美元請真人填問卷,跑焦點座談——結果通常慢,貴,而且受訪者說的跟實際行為對不上。Joon Sung Park 的賭注是:與其問人,不如建一個數位分身直接跑實驗。他是史丹佛 AI 實驗室出身的研究員,2023 年以一篇俗稱Smallville 論文的生成式代理人研究轟動學界——那篇論文至今在 Google Scholar 累積超過七萬二千次引用,是近年被點名最多次的 AI 年度最佳論文。他隨後創辦 Simile,核心主張只有一句話:現有的大型語言模型學的是人在網路上說了什麼,但他要建的模型要學人實際怎麼活。這場訪談從他在首爾的童年一路聊到模擬八十億人的終極野心,中間夾著幾個值得你認真聽的判斷。
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
這場訪談有五個值得說的點。第一,為什麼 ChatGPT 這類模型不能直接拿來做人類行為預測,以及差距有多大。第二,Simile 怎麼收資料,怎麼驗準確度,以及那個 85% 數字背後的意義。第三,模擬和預測根本是兩件事——這個區分決定了這門生意的邏輯。第四,市調是百億美元產業,但 Park 認為那只是起點,真正的 addressable market 是所有為人做的決策。第五,從隔離模型到氣候變遷,模擬這條路有一位諾貝爾獎得主已經走過一段,Park 想接著走。合起來,這是一個學術背景的創辦人在解釋為什麼他選了一條比做 AI 助理更迂迴,但他認為更根本的路。
◎GPT 預測人類行為,準確率掉到兩三成
這是整場訪談裡最硬的數字,也是 Simile 存在的核心理由。Park 的說法是:GPT,Claude 這類前沿模型是被訓練成超理性客觀機器,它們學的是網路上人說了什麼,不是人實際做了什麼。他把這個差距叫做 attitudinal data 和 behavioral data 的鴻溝——前者是態度,後者是行為。他們的測試結果是:在一般大眾議題上,前沿模型預測人類行為的準確率約 50 到 60%;一旦換成客戶真正在意的利基族群,會掉到 20 到 30%。Simile 的目標是把這個數字拉到 85%。他說的最有趣的一句話是:我們要建的模型必須跟人一樣蠢——如果你會犯這個錯,模型也要犯同樣的錯。這聽起來像是在開玩笑,但這才是行為預測的核心難題。
◎85% 準確率怎麼來的,以及憑什麼信這個數字
Park 詳細說明了他們的驗證方法:招募一千位具美國代表性的受訪者,花兩小時收集訪談和行為資料,建出數位分身,兩週後把真人召回,讓真人和數位分身分別完成同一套測試——包含大五人格量表,行為經濟學實驗,以及已發表在 PNAS 期刊的隨機對照試驗。結果是數位分身複製真人行為和態度的準確率,達到真人自我複製的 85%。這篇論文叫 Generation Simulations of a Thousand People,是 Simile 建立學術可信度的基礎文件。另一篇後續論文則用了 Open Science Foundation 上數萬筆預先登記的真實社科實驗來後訓練模型,目的是證明隨機對照試驗的資料能顯著提升模型預測人類行為的能力。方法論是透明的,數字是可溯源的,這在這個領域不是理所當然的事。
◎模擬不是預測,而是找到改變結果的路徑
Park 花了不少時間解釋一個很多人會搞混的區別。預測是告訴你未來會發生什麼;模擬是告訴你要採取哪些步驟才能得到你想要的未來。他舉了一個汽車公司的例子:你想拉高電動車銷量,模擬跑出來的答案可能是某個行銷方案雖然有效,但會同時傷害燃油車的整體銷售,淨效果是負的。如果你只盯著電動車這個指標,你永遠看不到這個風險。他還引用了科幻小說《基地》裡的心理歷史學做類比——模擬出來的第一步行動往往反直覺,但那才是正確的路徑。這個區分決定了 Simile 的產品邏輯:他們賣的不是預測報告,而是決策路徑。
◎市調百億美元只是起點,真正的市場是所有人類決策
有人問 Park 市場規模,他說市調產業大約是一千億美元。然後他說這個數字不是他的 TAM。模擬的目標是參與所有為人做的,關於人的決策——產品上市,政策制定,組織管理。他的說法是:每天有無數決策在會議室裡被做出,但真正去問過利害關係人的少之又少,因為問人很貴,很慢,而且人根本沒空回答一千道問卷題。他說 Simile 想做的事是確保人的聲音永遠出現在那個會議室裡。這個框架比更便宜的市調工具野心大很多,但也更難驗證。他自己承認:我是研究員出身,我沒有算過這個 TAM,我只是假設它一定很大。這是誠實的說法。
◎Thomas Schelling 的隔離模型到模擬氣候變遷,這條路走了五十年
Park 提到了一位對他影響深遠的學者 Thomas Schelling——1970 年代的諾貝爾經濟學獎得主,代理人模型的先驅。Schelling 的種族隔離模型發現:即使每個人對於鄰居種族的偏好只有輕微差異,長期下來整個社會仍會完全隔離。這個反直覺的發現後來影響了美國的混合收入住宅政策。Park 的觀點是:那個時代的模型只有紅點和藍點,描述能力太粗糙;現在有了生成式 AI,可以建出高擬真度的代理人,才有機會真正解決複雜的社會問題。他的終極目標是模擬八十億人,回答氣候變遷,民主崩潰,貨幣制度起源這類問題。他說他認為這條路上有一個諾貝爾獎等著被拿走——說這句話時,他大概不是在開玩笑。
Park 是少數能把學術嚴謹和商業野心同時說清楚的創辦人。他的核心賭注是:在 AI 助理和自動化工具搶盡版面的時候,真正稀缺的能力是準確理解人。他選了一條更慢,更難的路來建這個基礎,而那個 85% 的數字和背後的方法論,目前是他最有力的籌碼。這門生意能走多遠,取決於他能不能讓客戶相信:花錢模擬,比花錢試錯便宜。
Park 說明 2020 年進入史丹佛 PhD 時,GPT-3 剛出現,整個學界在問這個模型到底有沒有用;他們決定把最大的賭注押在重建我們生活的世界這個方向上,而不是做分類或生成任務。
Park 區分了兩種情境:模型已有的社會物理學只需要 prompt 就能引出;但人類行為中大量的深層行為規律,現有模型根本沒有學到,必須透過訓練才能注入。他把這些未被捕捉的行為規律稱為人類的 dark knowledge。
說明論文設計:招募一千名美國受訪者,收集兩小時資料,建數位分身,兩週後召回真人做同套測試,數位分身複製準確率達 85%。同時指出前沿模型在利基族群行為預測上可能掉到 20–30%。
用汽車公司電動車行銷的例子說明:模擬的價值不在預測結果,而在找出達成目標的路徑;某個行銷方案可能拉高電動車銷量但傷害整體業績,只看單一指標會做出錯誤決策。並引用《基地》心理歷史學做類比。
說明 Schelling 1970 年代的種族隔離模型:微小的鄰居偏好差異長期造成社會完全隔離,這個發現影響了美國混合收入住宅政策;Schelling 後來獲諾貝爾經濟學獎。Park 認為生成式 AI 讓這類模型終於有機會達到足夠高的擬真度。
提到 Sam Altman 資助了一項 UBI 實地研究,花費 1400 萬美元,歷時五年,得到一個發現。Park 的觀點是:如果能用模擬跑,同樣的問題可以重複測試,即時得到結果,這正是模擬相對於實地研究的核心價值。
Simile 總部在舊金山 Mission Rock,紐約設有小型辦公室,全公司約 60 人,近 20% 是 Park 在史丹佛實驗室的舊同事。共同創辦人包括:Percy Liang(提出 foundation model 一詞),Michael Bernstein(人機互動研究者),以及負責商業的 Laney。
看完今天的,讓明天的自己送上門
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
已出刊 104 期 ・ 隨時可退訂