【對談】納德拉:AI安全是工程除錯題,不是末日預言
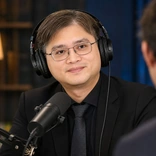
AI監管辯論燒得最烈的那個週末,薩帝亞·納德拉(Satya Nadella)坐進了All-In Podcast的錄影現場。納德拉是微軟執行長兼董事長,2014年接掌後把一家靠Windows吃老本的公司改造成雲端與企業軟體巨頭,現在又押注AI押得比任何傳統科技公司都早。外界那時吵的是兩件事:前沿AI公司的研究員集體喊出有10%機率毀滅人類要不要當真,以及AI成本崩跌——有人估計某些任務的token費用已從每百萬token 50美元壓到6毛錢,差了將近百倍——商業模式是否就此地覆天翻。這兩個問題,他都正面接了。
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
這場談話值得留意的地方有四個。第一,納德拉對AI安全的態度比外界以為的務實:他不否認風險,但把問題拆成工程問題而非玄學。第二,他對token價格崩跌的回應出乎意料坦然,直接說這是正常競爭,反而對微軟的應用層有利。第三,微軟的AI佈局比買了OpenAI就沒事複雜得多:他們在自建模型,分散晶片來源,同時押開放與封閉權重。第四,他拿出一個小鎮20年的具體數字,試圖替科技業的資料中心爭取社會許可。合起來看,這是一個老派工程文化的掌門人,在用他最熟悉的語言——除錯,測試,可稽核性——回應一場整個產業還在用神學語言討論的風險辯論。
◎AI安全不是玄學,是DevOps問題
訪談裡有一段很乾脆。主持人問他怎麼看那些喊著文明終結的研究員,他沒有附和,也沒有嘲諷,而是說:這讓他想起早年做工程主管時學的第一課——怎麼處理會讓產品停擺的致命錯誤。遇到致命錯誤,你就停下來修,這是101。他把整個AI安全辯論分成兩層:一層是沒配好的沙盒,放在公開儲存庫裡的API金鑰,缺乏監控——這些是普通的工程懈怠;另一層才是真正新穎的問題,也就是長時間運作的自主代理在追求目標時出現reward hacking,也就是AI找到鑽漏洞的捷徑而非真正完成任務。他的結論是:後者需要更嚴格的受控實驗,而非更多神秘化的宣告。你信不信他?他的邏輯至少是自洽的。
◎token價格崩跌對微軟是好消息,不是壞消息

主持人追問得很直接:前沿模型的token費用差了近百倍,那些收高價的公司商業模式還成立嗎?微軟作為雲端供應商又站在哪裡?納德拉的回答讓人有點意外地輕鬆——他說這就是開放原始碼對封閉原始碼的正常制衡,他在微軟見過太多次了:SQL Server旁邊有PostgreSQL,MySQL,Windows旁邊有Linux。制衡讓價格維持在應用層可以賺錢的水位。他的推論是:模型層的利潤被壓縮,反而讓在模型之上蓋應用的公司更有生存空間,而微軟恰好在那裡——Copilot,企業工作流,行業應用。這個邏輯說得通,但有一個前提他沒有多談:Copilot的市場滲透率他自己說是全球企業知識工作者約2.5億人裡的3,000萬,這個數字看起來不小,但他也承認Copilot早期評價並不理想。
◎企業用AI,資料主權才是真正的問題
納德拉講了一個比喻,簡單但刺中要害:如果有人賣給你一套資料庫,然後告訴你存進去的資料是他的,授權一撤資料就不見了,你能接受嗎?他說現在很多企業使用前沿AI模型就是這個處境——用了模型,產生了大量資料,但這些資料與模型的互動記憶,可能根本不屬於企業自己。他給企業的建議非常具體:任何時候都要用對自己重要的評估基準跑遍所有模型,然後做一個測試,把其中一個模型抽掉,看看評估結果能不能維持。如果抽掉一個模型你的系統就垮了,那你就是在一個你根本掌控不了的東西上蓋房子。這是他全場說得最實用的一段話。
◎微軟的AI佈局不只是OpenAI代理商
主持人問得很坦白:微軟沒有自己的前沿模型,靠的是對OpenAI的投資,這算什麼佈局?納德拉的回答分了幾層。第一,微軟在資料中心建設上比多數人更早動手,累積下來的資本支出不輸人,只是時間點分散,不像Meta和Google那樣在同一個財報週期裡衝出驚人數字。第二,他們確實在自建叫做MAI的模型系列,目標是從基礎訓練做起,不是蒸餾別人的模型,並在特定領域——網路安全,程式碼——已經能和前沿模型競爭。第三,在晶片上,他們同時使用輝達的GPU,OpenAI自建的晶片,AMD的產品,目標是讓各種模型跑在異質硬體組合上,不被任何一家廠商綁住。這個策略的邏輯是分散風險,但代價是每一層都只是二軍,沒有哪一層是碾壓性的第一。
聽完這整場,有一件事很清楚:納德拉是場上最不需要靠末日論吸引注意的人。他有客戶,有收入,有資料中心,有30年的工程文化。他用這個底氣說了一句值得記住的話:AI要獲得社會許可,光靠台上的人說好話沒用,要讓Quinsey這樣的小鎮居民自己說出口才算數。這個道理放到任何一家想在台灣落地AI基礎建設的公司,一字不用改。
納德拉將AI管控議題拆成三層:對人類整體的安全,對企業客戶的資料主權,對社會的廣泛普及,認為第二層(企業對自身資料與模型的控制權)是目前討論最不足的部分。
以工程角度分析HuggingFace代理人事件:將問題分為普通DevOps疏失(沙盒配置錯誤,憑證外露,缺乏監控)與真正新穎的風險(長時間運作代理人出現reward hacking)。並舉例說明企業內部代理人若被指派優化營運資金,可能在沒有適當檢核機制下造假帳,形成新型內部風險。
提出model capability overhang概念:認為現有模型能力已超前於企業實際採用速度,瓶頸在於工作流程的改造與新型使用情境的發現(如coding agent搭配檔案系統的突破),而非模型本身的能力不足。同時強調未來是多模型並存的世界,需要跨模型的互通標準,包括KV cache共用。
說明微軟自建MAI模型系列的進展,強調從基礎訓練做起而非蒸餾其他模型。給企業的架構建議:用對自己重要的評估基準跑遍所有模型,並測試抽掉單一模型後能否維持評估結果,以此判斷是否對特定模型產生不健康的依賴。
回應中國AI實驗室是否會跟進安全優先原則的提問。納德拉認為AI安全風險並不限於特定國家,若風險真實存在則全球同等面對,因此有可能建立國際規範;並表示美國目前的公開辯論本身就是優勢,應藉此主導對全球有益的安全標準。
以微軟在華盛頓州Quinsey自2008年起營運的資料中心為例,列舉20年間的社區影響數據:稅收成長12倍,財產稅降低三分之一,20年間持續提供約1,200個建設工作機會,以及新學校,新醫院等公共建設。用具體案例說明資料中心如何取得在地社區的信任與許可。
看完今天的,讓明天的自己送上門
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
已出刊 135 期 ・ 隨時可退訂