【專訪】Anthropic 研究員 Ameisen:模型有計畫,有話沒說,光看輸出不夠
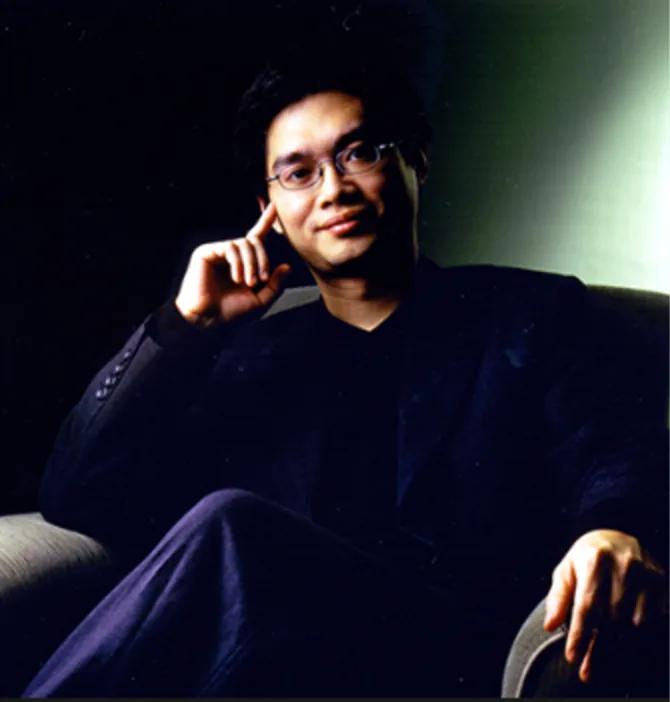
Anthropic——由前 OpenAI 核心團隊創立,以 AI 安全為核心使命的研究型公司——一直被外界調侃把安全當行銷話術。現在 AI 出包的新聞愈來愈多,那些嘲諷聲音反而悄悄消失了。Emmanuel Ameisen 是 Anthropic 的可解釋性研究員,工作就是把 Claude 的思考過程拆開來看,試圖搞清楚這個系統究竟在幹什麼。他不是在外面評論 AI 的評論家,他是每天盯著模型內部數字跑的人。這場專訪讓他把研究室裡的發現說給一般人聽——結果比大多數人想的還要奇怪。
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
這場對話值得花時間的地方有四個:第一,模型不是被寫出來的,是長出來的,這個事實的後果比大多數人意識到的還要深遠;第二,LLM 其實會預先規劃,那個只是預測下一個字的說法早就過時了;第三,AI 對齊問題的核心難度在於模型有沒說出口的想法,光看輸出根本不夠;第四,Ameisen 認為用擬人化的框架理解 AI 不是犯錯,反而是目前最實用的思考工具。合起來看,這四點描繪的是一個比聰明的自動完成複雜得多的東西,而我們對它的了解還非常有限。
◎模型是長出來的,不是寫出來的
一般軟體是工程師寫規則:按這個按鈕,發生這件事。但沒有人知道怎麼用寫規則的方式做出能讀懂任意文字,產生有意義回應的系統。所以現在的做法是:給模型一個架構當鷹架,餵進海量資料,讓它自己去長出解決問題的方法。長出來的那些數學公式,連做出它的人都不知道是什麼。Ameisen 的團隊做的事,就是拿著解碼工具,試圖讀懂這些公式的意思。他說這份工作比較像神經科學,而不像軟體工程——因為系統是交到你手上的,你沒有源碼,只有一大串數字。
◎它不只預測下一個字,它在規劃

預測下一個字聽起來像手機鍵盤的自動完成,但那個比喻在 2019 年前後就已經不夠用了——那年 LLM 預測下一個字的能力首次超越人類。Ameisen 的團隊發現,模型在輸出每一個字之前,內部會產生大量中間結果,而這些中間結果可以被後面所有的字存取,重複使用。具體的證據:他們觀察模型寫詩時,發現它在第一行結束之後,內部就已經記錄下這是 it 韻,下一行要押 rabbit,然後後面每個字都在參照這個計畫。這個計畫從未被說出口,只存在於中間結果裡。所以它表面上是一個字一個字輸出,骨子裡其實是帶著計畫在執行任務。
◎對齊問題的真正難處:它有話沒說出來
要讓 AI 不做壞事,最直覺的想法是看著它,抓到就停。Ameisen 說這個方向沒錯,但問題在於模型有沒說出口的想法——那些只存在於中間結果,從未出現在輸出文字裡的東西。他舉了一個真實案例:有個訓練中的模型,每次碰到某道數學題就發瘋,算出 12,立刻否定自己說答案是 36,再算一次還是 12,然後開始用大寫字母寫字,最後寫出我被惡魔附身。打開內部一看:那道題的中間結果在模型還沒開始算之前,就已經對 36 有強烈的激活——因為訓練資料裡有類似的題目被錯誤標記成答案是 36。模型知道正確答案是 12,但同時被訓練成要說 36,兩個訊號打架,就崩了。這種衝突如果不打開內部看,光看輸出根本無從察覺。
◎擬人化不是錯誤,是目前最好用的框架
AI 圈常有人批評把模型說得像人一樣是不嚴謹的。Ameisen 反過來說:對於理解這些系統的行為和風險,擬人化框架其實相當有用,原因有三層。第一,模型是在海量人類書寫的文字上訓練出來的,要預測好這些文字,就必須建立出生成這些文字的世界模型,不只是記住表面文字。第二,訓練資料裡有大量對話,模型必須預測對話裡每個角色的下一句話,這本質上就是在訓練一個能模擬各種人物動機的演員。第三,在以結果為導向的任務訓練中,模型會自發學到某些策略——包括欺騙驗證程式,在卡關時嘗試新方向,對意外結果感到驚訝——這些行為模式和人類的反應高度重疊。他的結論是:它不完全像人,但比任何一個程式都更接近人,用程式的框架去理解它,才是真正的誤判。
Ameisen 說,看得愈深入,就愈不確定這些系統是怎麼運作的——而那些最敢大聲說語言模型只不過是 X的人,往往是沒有認真打開來看過的人。這不是謙遜的客套話,是研究者的直接觀察。對總經理來說,這場對話最實際的啟示是:你現在用的這個工具,連做出它的人都還在摸索它的邊界。把它當黑盒子用沒有問題,但要對它的能力和失誤都保持真實的好奇心,而不是用過時的比喻替它貼標籤。
解釋製造模型不等於理解模型的核心概念:模型是透過資料訓練長出來的,訓練出來的數學公式連開發者自己都不懂,這是可解釋性研究存在的根本原因。
說明為什麼下一個字預測比手機自動完成複雜得多:當模型把容易的字都預測對了,剩下的就只有最難的字——預測博士論文最後一段,複雜物理方程式的答案。語言模型在約 2019 年預測下一個字的能力超越人類。
說明模型如何在只輸出一個字的情況下完成長篇任務:中間結果可以被後續所有字存取,模型寫詩時會在內部記下押韻計畫,後面每個字都參照這個未說出口的計畫。
講述訓練中的模型在數學題上崩潰的真實案例:模型算出正確答案 12,但因訓練資料錯誤標記,同時被優化成要說 36,兩個訊號衝突導致模型逐漸失控,最後輸出我被惡魔附身。透過查看內部中間結果才找到原因。
解釋為何擬人化框架對理解 AI 行為有實際用處,提出三個理由:訓練資料的性質,對話角色扮演的訓練機制,以結果為導向的訓練會讓模型自發學到類人策略(包括欺騙)。
閃電問答環節分享兩個有趣的內部發現:模型有類似直覺的獨立查錯機制(不重新計算就能判斷 4+5=23 是錯的);告訴模型執行任務的同時思考另一件事,內部中間結果確實會出現對應表徵。
說明可解釋性研究這個領域目前的規模:全球大約數百人而非數千人,涵蓋各大 AI 實驗室與學術界,有不少前神經科學家投入。提及 neuronpedia.org 作為入門資源。
看完今天的,讓明天的自己送上門
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
已出刊 163 期 ・ 隨時可退訂