【專訪】Rich Sutton:ChatGPT 不會學習,整個產業走岔了
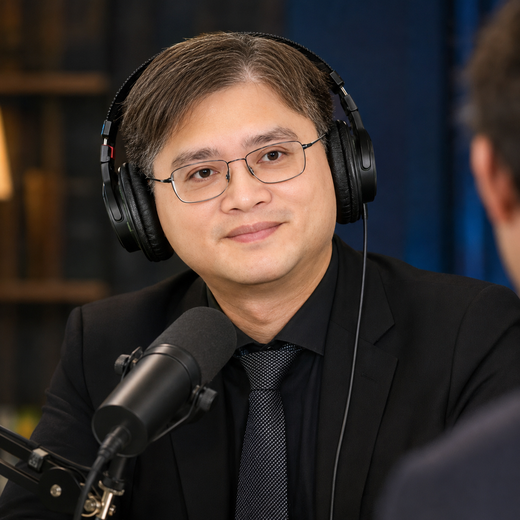
強化學習(reinforcement learning)這個詞你大概聽過,但你不一定知道它是誰發明的。Rich Sutton,加拿大電腦科學家,強化學習領域的奠基人,寫了這個領域的教科書,帶出了 AlphaGo 背後的核心人物 Dave Silver。他在 2019 年寫了一篇短文叫 The Bitter Lesson,意思大致是:幾十年來,每次 AI 研究者把自己的人類知識塞進系統,最後都輸給了那些乾脆讓演算法自己從大量運算中學習的方法。這篇文章現在是 AI 圈的聖經級文件,Sam Altman 那圈人幾乎人手一份。現在,Sutton 和他的前學生 Kuram Javeed 一起創辦了新公司 Oaklab,帶著一套跟當前主流完全不同的技術路線出來創業。他接受了這場專訪,把他對 ChatGPT 這類大型語言模型的真實看法,一句一句說清楚了。
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
這場訪談值得注意的地方有四個,合起來是一個完整的挑戰聲明。第一,Sutton 認為 ChatGPT 這類大型語言模型根本不會學習,用完就凍結,這不是 AI,這是一本很貴的百科全書。第二,他認為現在各大實驗室瘋狂投入的合成資料路線是個大錯誤,因為世界無限複雜,任何人造的模擬都只是縮影。第三,他和 Javeed 提出的解法是持續深度學習,讓模型的權重在使用過程中一直更新,而不是訓練完就鎖死。第四,他們的目標是用一個單一設計,低能耗的架構,讓不同版本的系統從各自的真實經驗中學出不同的智能。這四點加在一起的意思是:Sutton 認為整個產業走岔了,而他要用一家小公司來證明這件事。
◎大型語言模型是 AI 的一部分,不是全部
Sutton 說得很直接:大型語言模型是一個了不起的科學突破,是神經網路在語言運用上的重大進展。但他同樣直接地說,這頂多佔智能的 20% 到 25%,把它當成 AI 的全部是在裝。他的原話大意是,我們應該慶祝這個進展,而不是讓它假裝自己就是全部的智能。這不是客氣話,這是他對整個產業現狀的診斷。他的核心批評是:現在的大型語言模型訓練完就凍結權重,使用者跟它互動再多,它也不會因此變得更聰明。這在他眼裡是根本性的缺陷,因為真正的學習從來不是一次性的事。
◎合成資料是死路,因為世界比任何模擬都大
現在各大 AI 實驗室的下一步是合成資料——因為網路上的真實人類資料快用完了,就讓模型自己產生訓練資料。Sutton 和 Javeed 的回應是:這是下一個大錯誤。他們提出的概念叫 Big World Hypothesis,意思很簡單:世界無限複雜,任何人寫出來的模擬程式都只是一個極小的縮影。Javeed 舉了一個具體例子:如果你想訓練一台用聲納定位飛行的無人機,就像蝙蝠那樣,你需要的合成資料得先請領域專家設計,而那些專家本身就是瓶頸。更根本的問題是:誰來判斷哪些合成資料是好的?現在的答案是人類工程師。只要人還在這個迴路裡,就不可能真正規模化。他們的結論是:讓系統直接從自己的真實經驗中學,才是唯一能繞開這個瓶頸的路。
◎持續深度學習:讓權重一直動,不要鎖死
Sutton 和 Javeed 提出的技術解法叫 continual deep learning,核心概念是讓模型的權重在部署之後仍然持續更新,而不是訓練完就凍結。現在的做法最大的問題叫 catastrophic forgetting——如果你只拿一個新樣本去更新整個模型,舊知識會被破壞殆盡。他們的解法有兩個關鍵:第一是讓網路裡每一個權重都有各自的更新速度,大部分權重動得很慢,只有在對的地方才快速更新。第二是一個叫 continual backprop 的演算法,做法類似農業裡的輪作——持續在網路裡植入隨機初始化的新單元,讓系統保持更新的能力,而不是讓所有的隨機性在訓練初期就消耗殆盡。這個演算法幾年前已發表在 Nature 期刊。Oaklab 的目標是把這套方法做到可以從頭訓練一個新的基礎模型,讓它在學習知識的同時,也學會如何繼續學習新事物。
◎大型實驗室為什麼不做這件事:陷在局部最低點出不來
主持人問了一個很實際的問題:如果這條路是對的,OpenAI 和 Anthropic 這些有幾千個工程師的地方為什麼沒有在做?Javeed 的回答很坦白:因為任何新的演算法路線,在初期一定會比現有方法更差,效能會先退步再進步。大型實驗室已經深度綁定在現有產品上,沒辦法接受這個過渡期。他用的詞是局部最低點,意思是:現在的路線還能繼續往前走,所以沒有人願意退一步找別的路。Sutton 補了一句更刻薄的觀察:大型實驗室裡可能有人知道怎麼做得更有效率,但同一個實驗室裡有十倍的人在做其他事情,資源根本不往這個方向走。這就是為什麼他們選擇從小公司出發,刻意保持團隊精小,讓每個人都真正理解並認同這個方向。
Sutton 今年說的話,和他 2019 年寫 The Bitter Lesson 時說的話,本質上是同一句:不要把人類知識塞進系統,讓演算法自己從運算和經驗中學。當年這句話是在批評符號 AI,現在這句話是在批評大型語言模型。產業換了一輪主角,他的診斷還是一樣。Oaklab 現在是一家剛起步的小公司,要對抗的是整個產業的慣性。這種事以前發生過,結果有輸有贏。但 Sutton 這個人,你很難說他只是在說說而已。
Sutton 解釋 The Bitter Lesson 的核心:不要被人類知識分心,專注在能隨運算規模擴展的學習方法,例如搜尋與學習本身。
Sutton 說大型語言模型對 The Bitter Lesson 而言同時是正面例子也是反面例子:前期靠大量運算擴展很成功,但最終受限於網路上有限的人類資料。
Javeed 提出 Big World Hypothesis:世界無限複雜,合成資料永遠只是縮影,人類專家仍然是瓶頸,以無人機聲納定位為例說明。
Sutton 直接點名大型語言模型的根本問題:權重在部署後完全不再更新,卻聲稱能達到博士等級的能力,他認為這是不可能的事。
Javeed 解釋 catastrophic forgetting 的問題與解法:step size optimization 讓每個權重有各自的更新速度;continual backprop 持續注入新的隨機初始化單元,已發表於 Nature 期刊。
Javeed 說明為何大型實驗室不走這條路:新演算法必然先退步再進步,已深度綁定產品的大型實驗室無法承受這個過渡期,是局部最低點的問題。
Sutton 明確說大型語言模型是神經網路在語言運用上的重大突破,但他估計這只佔完整智能的約 20% 到 25%,整個產業把它當成全部的 AI 是一種誤導。
看完今天的,讓明天的自己送上門
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
已出刊 106 期 ・ 隨時可退訂