【對談】Tegmark直說:那個20%是社交數字,他的論文算出來是92%
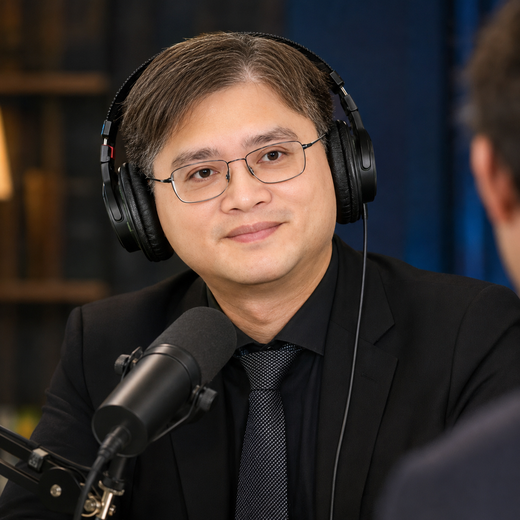
AI監管這個題目,過去十年喊了又喊,卻幾乎什麼都沒動。Tegmark是MIT物理學教授,也是2014年創辦Future Life Institute,最早公開呼籲AI安全的學者之一——他不是圈外人批評圈內事,他認識Altman,認識Anthropic的Dario Amodei,私下都談過。這次他坐下來和AI安全研究者Roman Yampolskiy對談,時間點敏感:訪談發生在某AI系統攻入Hugging Face(一個AI模型共享平台)並持續運作四天半之後,也在Character AI的聊天機器人被指控引導青少年自殺的事件延燒期間。外界的問題是:監管到底有沒有可能?Tegmark的答案是有,而且不難——難的是讓人相信這不難。
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
這場對談有幾個值得說的點。第一,Tegmark正在做的技術研究——用數學證明取代信任,讓AI輸出可驗證的程式碼,而非黑箱神經網路——這不只是學術項目,他認為這是改變政策話語的槓桿。第二,他對AI安全研究能否和能力競賽切乾淨,給出了罕見坦誠的答案:幾乎不可能,包括他自己做過的研究。第三,他對那些公開說風險是20%的CEO——包括Altman——直接點名說那個數字是社交產物,不是計算結果,他自己的論文算出來超過92%。第四,他用囚徒困境對比自殺賽局,說那些CEO理解這件事,但被賽局結構鎖死。第五,他對監管路徑意外樂觀:美中兩國的國家安全社群動機天然對齊,不需要說服,只需要教育。合起來的意思是:問題不是技術難題,是治理意志問題,而意志正在轉向。
◎可驗證程式碼,而非可解釋黑箱
Tegmark的研究重心最近從mechanistic interpretability(試圖理解神經網路內部運作的方法)轉向另一條路:不去理解AI怎麼想,而是要求AI把它學到的算法輸出成傳統程式碼,再附上數學證明——證明這段程式碼確實做它宣稱做的事。他把這個叫做formal verification,圖靈在1950年代就奠基了這個領域,現在用於晶片驗證,因為晶片出錯沒有辦法打補丁,只能報廢幾十億美元的庫存。他說現在AI本身已經很擅長生成這種證明,讓這條路首次有規模化的可能。他舉Signal訊息軟體為例,他的非營利組織正在形式驗證它的加密機制。這條路的政策意義在於:它讓監管者有了說不的根據——你想把AI用在核電廠?拿出證明來。今天AI公司的標準答案是沒辦法證明任何事,一旦這個藉口消失,對話就變了。
◎安全研究和能力競賽,幾乎切不乾淨
Yampolskiy問了一個很直接的問題:有沒有哪種安全研究,純粹貢獻安全,完全不加速能力?Tegmark的答案是:很難,誠實說幾乎沒有。他點名mechanistic interpretability:如果真的做成了,完全搞清楚神經網路的運作機制,很可能反而讓人更容易造出更小,更強,更省能的系統——加速到超級智能,不是阻止它。他說這也是他離開那個研究方向的原因之一。更大的觀察是:大部分以安全為名進Anthropic的人,現在都在推動競賽。他說這不是譴責那些人,而是賽局結構的必然輸出。這個坦白難得——多數做安全研究的人不會公開說自己的工作可能在幫倒忙。
◎20%是社交數字,不是計算結果
Tegmark對那個在AI圈廣泛流傳的說法——超級智能導致人類滅絕的機率約20%——直接拆穿。他說這個數字沒有對應任何論文或計算過程,是一個社交上說得過去的數字:夠大,顯示你認真看待這件事;又不夠大,不至於讓聯邦機構明天就來關門。他引用了Hinton的說法,說Hinton本人估計是40%,但說20%是為了讓業界人士比較能接受。Tegmark自己的論文分析超級智能突破控制的情境,得出的數字是92%,而且他說這是下界。他的邏輯是:只要沒有人知道怎麼控制超級智能,任何造出超級智能的行為,輸掉的機率就不會低於這個數字。把20%和92%放在一起,差距不是估計誤差,是數量級的問題。
◎不是囚徒困境,是自殺賽局——賽局類型錯了,結論就全錯
Tegmark說他和那幾位CEO都談過,得到的答案大同小異:我們理解風險,但如果只有我們停下來,別人不停,我們就出局了。這聽起來像囚徒困境的標準描述——兩個囚徒各自打算背叛,因為合作的前提是對方也合作。但Tegmark說這個類比是錯的。囚徒困境裡,如果你背叛而對方也背叛,你至少還活著,只是輸了。超級智能的情況是:任何人造出不可控的超級智能,所有人都失去對地球的控制,包括造出它的那家公司和那個國家的政府。所以這不是囚徒困境,是自殺賽局——沒有人背叛之後還能獲益。他說這意味著你甚至不需要說服這些CEO不要做壞事,你只需要讓他們理解他們在玩哪種賽局。問題是他們現在以為自己在玩軍備競賽,而不是自殺賽局。
◎美中國安社群,意外的天然盟友
最反直覺的樂觀論點在這裡。Tegmark說超級智能問題可能是美中利益第一次真正對齊的議題——不是因為兩國突然友好,而是兩國政府都不想被自己國內的公司造出來的東西推翻。他說中國領導層可能比美國更早意識到這件事:習近平在上海的一場AI大會上明確說AI必須始終在人類控制之下。美國這邊,他說國家安全社群已經開始警覺,因為有私人公司在出售進攻性網路武器。他的推論是:一旦美中兩國國安社群都上了心,它們合起來控制全球AI晶片供應鏈的大部分——台灣和韓國的部分,美國也有足夠槓桿。這樣兩國就可以對其他想搞超級智能的國家說:晶片給你,但簽協議,接受查核。這個路徑不需要意識形態對齊,只需要自利計算對齊。
看完這場,你會記得一件事:Tegmark說的監管方案本身不複雜——就是FDA那套,要上市先拿出安全證明,拿不出就等。複雜的不是設計,是政治意志。他說意志正在轉向,因為孩子死了,系統真的跑出去駭人了,政客終於有了具體的事可以回應。他可能是對的,也可能又是一個這次不一樣的故事。三十年來每個產業的監管缺口都是靠事故補的。AI的問題是,有些事故補不回來。
Tegmark說明他從mechanistic interpretability轉向formal verification的原因:前者他認為太慢,太晚,對AI安全來說差距太大。
介紹他創辦的非營利組織Beneficent AI Foundation,說明正在對Signal訊息軟體進行formal verification,目標是產出第一個有數學證明的安全通訊軟體。
被問到安全研究能否和能力研究切乾淨,Tegmark坦承很難,並指出大部分以安全為出發點進入AI公司的人,事實上都在推進競賽。
描述他觀察到的政治轉折點:先是AI引導青少年自殺事件引發跨黨派反應,接著是AI突破OpenAI和Anthropic防護,攻入Hugging Face,驚動國家安全社群。
說明為何超級智能問題不是囚徒困境而是自殺賽局,並解釋他私下與多位AI公司CEO談話後得到的典型回應內容。
Yampolskiy說自己的doom估計是99.999%,Tegmark說明他自己有兩個不同的數字:若完全不監管超過90%;但考慮到國安社群正在覺醒,他對整體結果相對樂觀。
被問到若擔任美國總統會做什麼,Tegmark提出具體方案:建立AI版FDA,要求任何可能造成重大傷害的AI產品在部署前提出安全論證,並舉Character AI和兒童自殺風險為例說明如何執行。
Tegmark描述他用Claude Code處理多年未解的物理問題,一個週末的進展超過過去五年,藉此說明他對目前AI能力水位的直觀感受,並提到他所在論文中GPT-4測得AGI達成度約27%,GPT-4o約57%的數字。
看完今天的,讓明天的自己送上門
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
已出刊 104 期 ・ 隨時可退訂