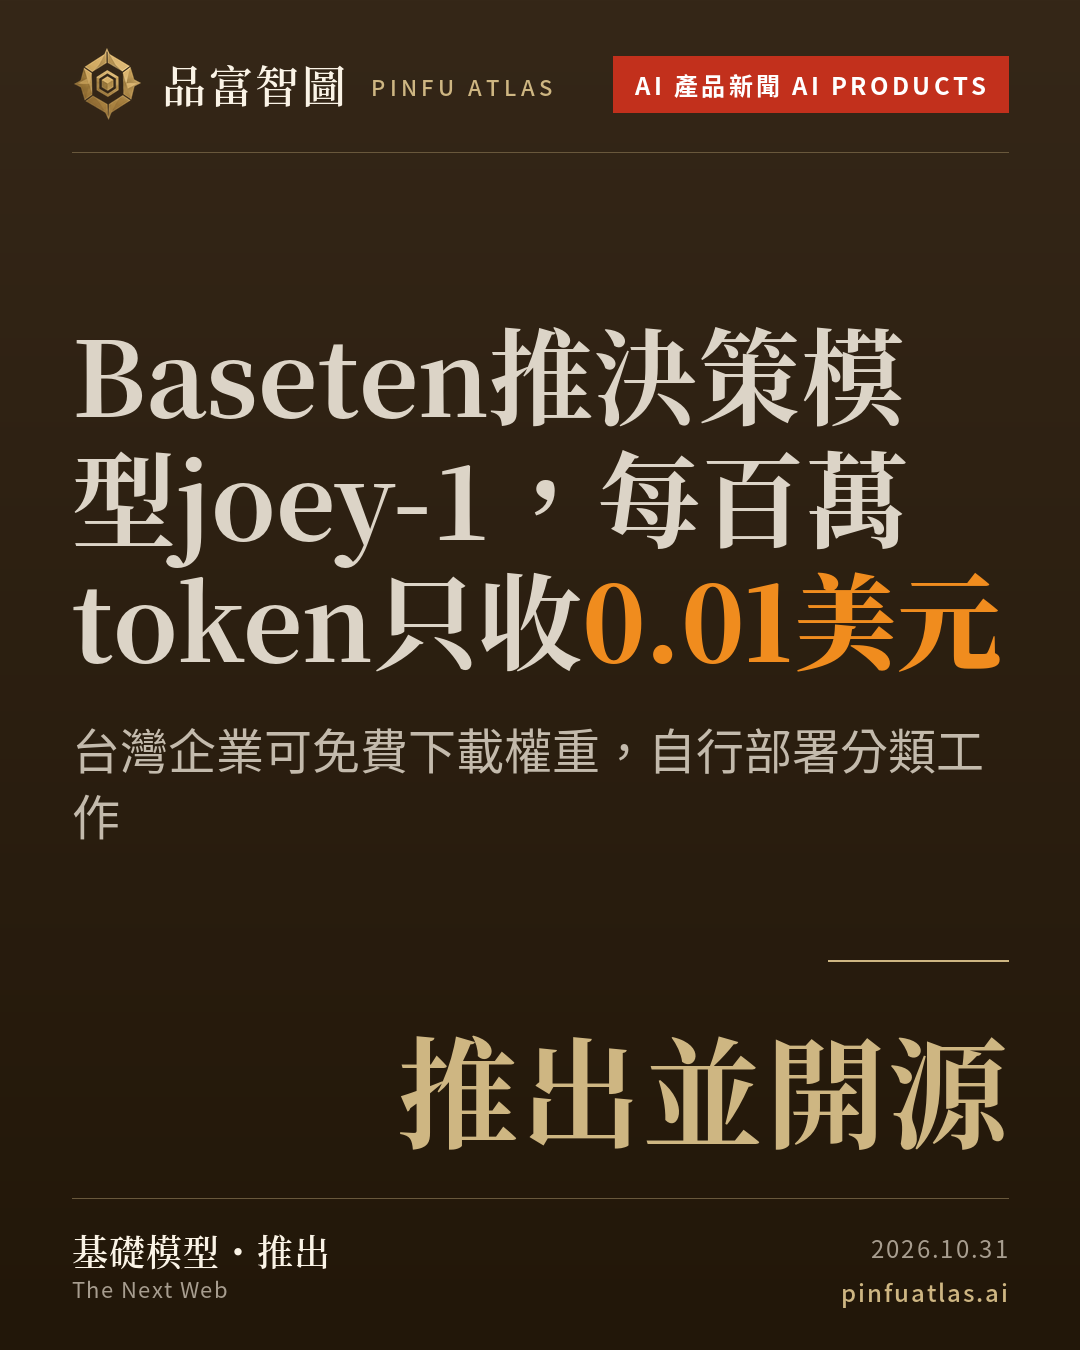
Baseten推決策模型joey-1,每百萬token只收0.01美元
Baseten週四推出開放權重決策模型joey-1,20億參數,不寫文字、只回答是非或選擇題並附機率;每百萬token收0.01美元,處理2,000 token請求約20毫秒。以阿里巴巴Qwen3.5-2B為基礎,權重在Hugging Face免費下載。微軟本月也推出同類模型,每百萬token 0.042美元。
企業大量的分類、判斷工作,例如分派客服單、擋垃圾訊息,不需要AI寫長文。joey-1只給答案和把握程度,Baseten稱每月分類一千萬張客服單約50美元,是自家大模型的十分之一,讓這類工作的AI成本大幅降低;但它自稱同級最強的測試尚未公開。
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
大家熟悉的AI模型都在寫文章、回訊息,Baseten這次推出的joey-1偏偏不寫字。這家專門幫企業執行AI模型的公司週四發表joey-1,它只回答是非題或選擇題,再附上一個代表把握程度的機率,每百萬token只收0.01美元,主打便宜又快。
企業每天有大量工作,其實只需要一個判斷:這張客服單該轉給哪個部門?這封信是不是垃圾郵件?使用者輸入的指令有沒有害?拿會寫長文的大模型來做這些事,就像請大律師坐在收發室蓋章,能力過剩,鐘點費也貴。決策模型不寫回覆,只交出答案和機率,省掉產生文字的功夫,自然便宜又快。
Baseten給的數字很具體。一般長度約2,000 token的請求,joey-1大約20毫秒就能回答,比自家的elephant-1快約2.5倍。如果每月要分類一千萬張客服單,用joey-1約花50美元,換成自家更大的mammoth-1要500美元。joey-1有20億參數,參數量大致代表模型規模,它和上週由Baseten研究部門Base Labs推出的mammoth-1、elephant-1,組成同一系列。
不過,Baseten稱joey-1是30億參數以下最強的決策模型,卻還沒公開支撐這個說法的測試。它在模型說明文件中列出的成績是:在Jev決策指數的230個模型裡排第37名,是40億參數以下模型的最高分。這套指數來自TypeSafe AI,該公司9月推出的Jev,也是同樣只給答案、不寫文字的做法。
joey-1的底子是阿里巴巴的Qwen3.5-2B,再用621萬筆決策範例訓練。權重在Hugging Face免費下載,採MIT授權,企業可以拿回去自己部署。這個市場已經有人在搶:微軟本月也以Qwen打造自己的決策模型,每百萬token收0.042美元。
Baseten本身來頭不小。它在6月募得15億美元,估值最高達130億美元,9月又買下沙盒新創Blaxel。
接下來要看,Baseten會不會公開它自稱同級最強的測試結果,以及在微軟、TypeSafe AI等對手夾擊下,企業會不會真的把大量分類、過濾工作,從大模型移到這類小而專一的決策模型上。
看完今天的,讓明天的自己送上門
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
已出刊 157 期 ・ 隨時可退訂