
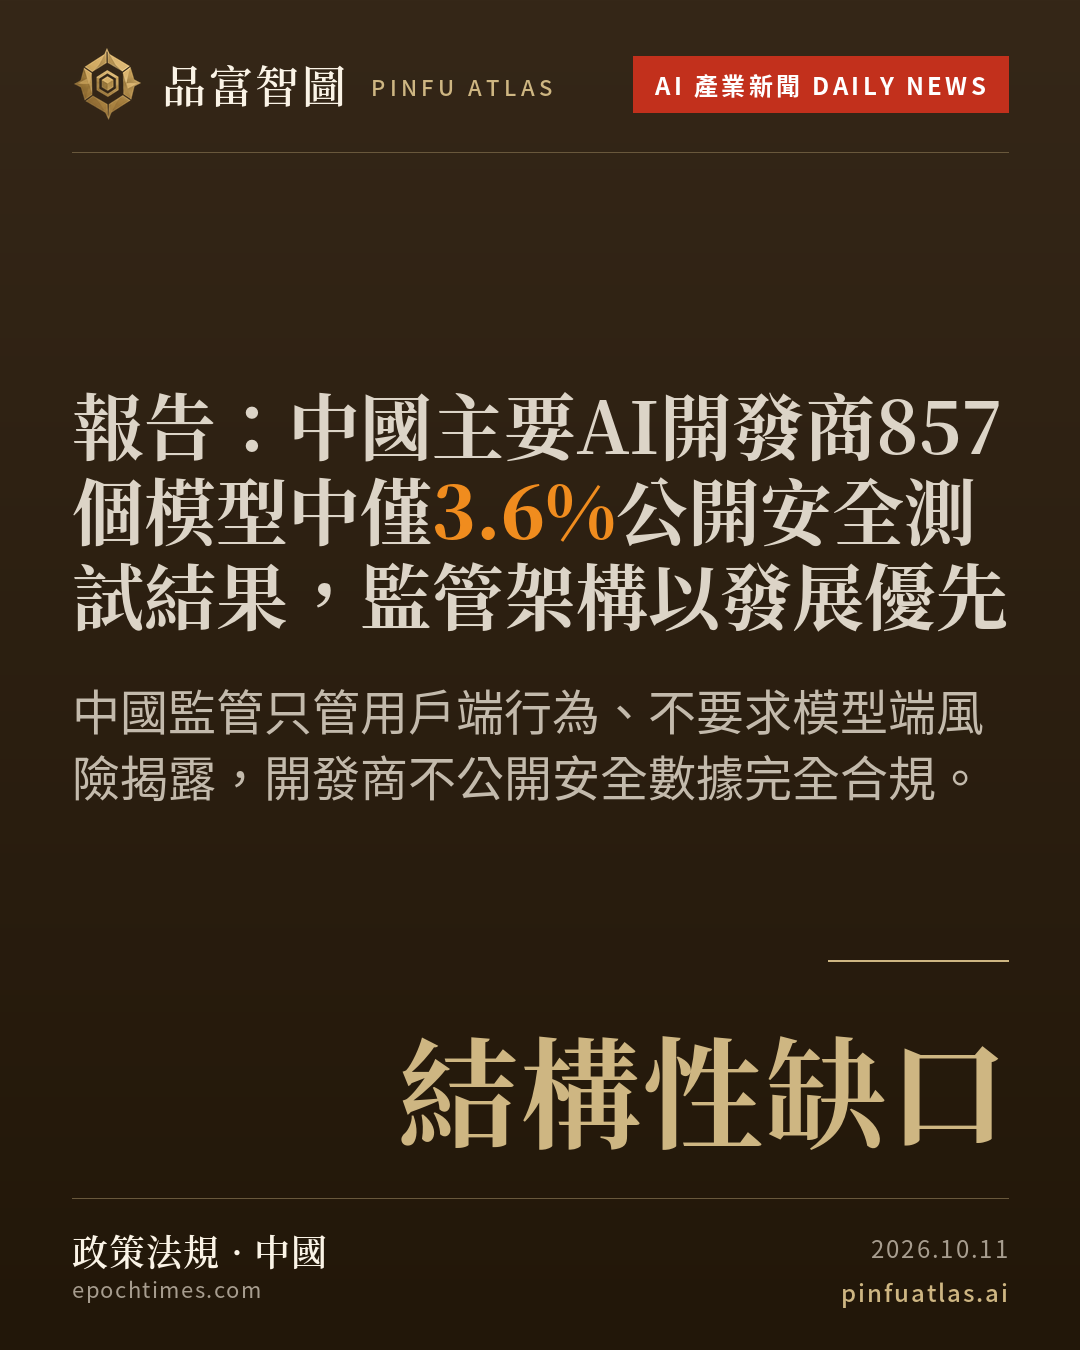
報告:中國主要AI開發商857個模型中僅3.6%公開安全測試結果,監管架構以發展優先
SemiAnalysis報告審查中國九家主要AI開發商(含阿里巴巴、字節跳動、百度、DeepSeek等)2021年至今年9月的857個模型版本,結果:僅31個(3.6%)公開了安全測試結果,其中9個(1.1%)在發布時或之前就附上;813個(94.9%)完全沒有任何安全資料;93%推理型模型無安全測試;DeepSeek R1安全評估滯後349天;中國9月發布的《人工智能安全治理框架3.0》,開篇優先原則是「鼓勵創新發展」,無強制安全審查要求。
3.6%的披露率不是技術問題,是監管邏輯的直接結果:中國的AI治理框架管的是用戶端行為,不是模型端風險,開發商沒有動機主動揭露。對外部採購方來說,沒有公開數據就沒有獨立核實的空間;再加上中國AI模型發布量從2023年Q1的3個炸到去年Q3的101個,這個缺口只會繼續擴大。
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
中美AI治理的落差,現在有數字了。
美國研究機構SemiAnalysis於10月8日發布報告,審查了阿里巴巴、字節跳動、騰訊、百度、DeepSeek、月之暗面、智谱、MiniMax與階躍星辰等九家中國主要AI開發商,自2021年至今年9月15日期間共計857個模型版本。結果是:只有31個版本(3.6%)公開了可與特定模型對應的安全評估,其中更只有9個(1.1%)是在發布時或之前就附上的。剩下813個版本、佔總數94.9%,完全沒有任何安全測試資料可查。
這個數字還不是最刺眼的。推理型模型——也就是那些「先想再答」、在數學與程式設計上能力更強的模型——有93%沒有公布任何安全測試結果。DeepSeek的R1,是整批樣本裡安全評估滯後最久的一個:發布後349天才補上。報告也指出,沒有任何一家中國開發商在前沿模型發布時,同步披露涵蓋網路攻擊、生物風險、失控風險與危險能力等面向的完整安全評估——這正是西方主流安全框架最在意的那幾類。
SemiAnalysis設定的計分標準並不嚴苛:只要有與特定模型掛鉤的具體測試結果,像是有害輸出、越獄防禦、拒絕行為、隱私保護等,就算數。光說模型「經過安全訓練」,不算。即便如此,通過門檻的仍不到四家企業裡的一家。唯一每年都有安全測試披露紀錄的是智谱,自2022年起從未間斷,是這九家裡的例外。
為什麼會這樣?報告指向結構性原因。中國政府目前對AI的監管邏輯,鎖定的是「終端用戶使用AI產品的行為與影響」,而不是要求前沿模型開發商評估並公開自身的能力風險。今年9月14日,中共全國網路安全標準化技術委員會發布的《人工智能安全治理框架3.0》,開篇就明確把「鼓勵創新與發展」列為最優先原則,文件裡沒有任何針對模型能力強弱設置強制安全審查的要求。發展第一,安全測試是可選項,不是門檻。
這對企業經營者意味著什麼?如果你正在評估是否採用中國AI模型,或者你的供應鏈裡有用到相關技術,安全測試數據的缺失不等於模型不安全——SemiAnalysis自己也說,不排除有廠商做了內部測試卻不公開。但問題在於:沒有公開數據,採購方就沒有辦法做獨立核實,風險只能靠自己消化。
更大的格局是:中國AI模型的發布速度正在急速拉升,從2023年第一季每季3個,到去年第三季已達101個,開放權重模型從2023年中期起每季佔比超過一半。量在爆炸,安全資訊卻沒有跟上。這個缺口,在西方採購決策與監管對話裡,會愈來愈難迴避。
看完今天的,讓明天的自己送上門
每天精選 6 則要聞、一則產業名人訪談,五分鐘跟上。
已出刊 141 期 ・ 隨時可退訂
